Simulación de agente inteligente autónomo
Agente en Python de tres etapas para una materia de IA: clasificar piezas industriales a partir de fotos del celular (KNN y K-Means escritos desde cero), planificar cómo reapilarlas con STRIPS/PDDL y cruzar un laberinto aleatorio con A*.
Trabajo final individual de Inteligencia Artificial I (UNCuyo, 2025).
- Python
- OpenCV
- scikit-learn
- NumPy
- PyQt5
- KNN
- K-Means
- STRIPS / PDDL
- A*
- pygame
El problema y el agente
La consigna pide un agente basado en objetivos que haga tres cosas en orden: reconocer cuatro tipos de piezas (clavos, tornillos, tuercas y arandelas) a partir de una foto, reordenar las cajas que las contienen en una pila objetivo y transportar la pila por un aula hasta un punto destino por el camino más corto.
Especifiqué el agente con la tabla REAS (rendimiento, entorno, actuadores, sensores) y traté cada etapa como un problema aparte. Las tres etapas son scripts separados: comparten el hilo conductor (los nombres de las clases pasan a ser los objetos del planificador) pero ningún código las conecta, y no hay un robot físico.
Etapa 1 — Fotos y base de datos
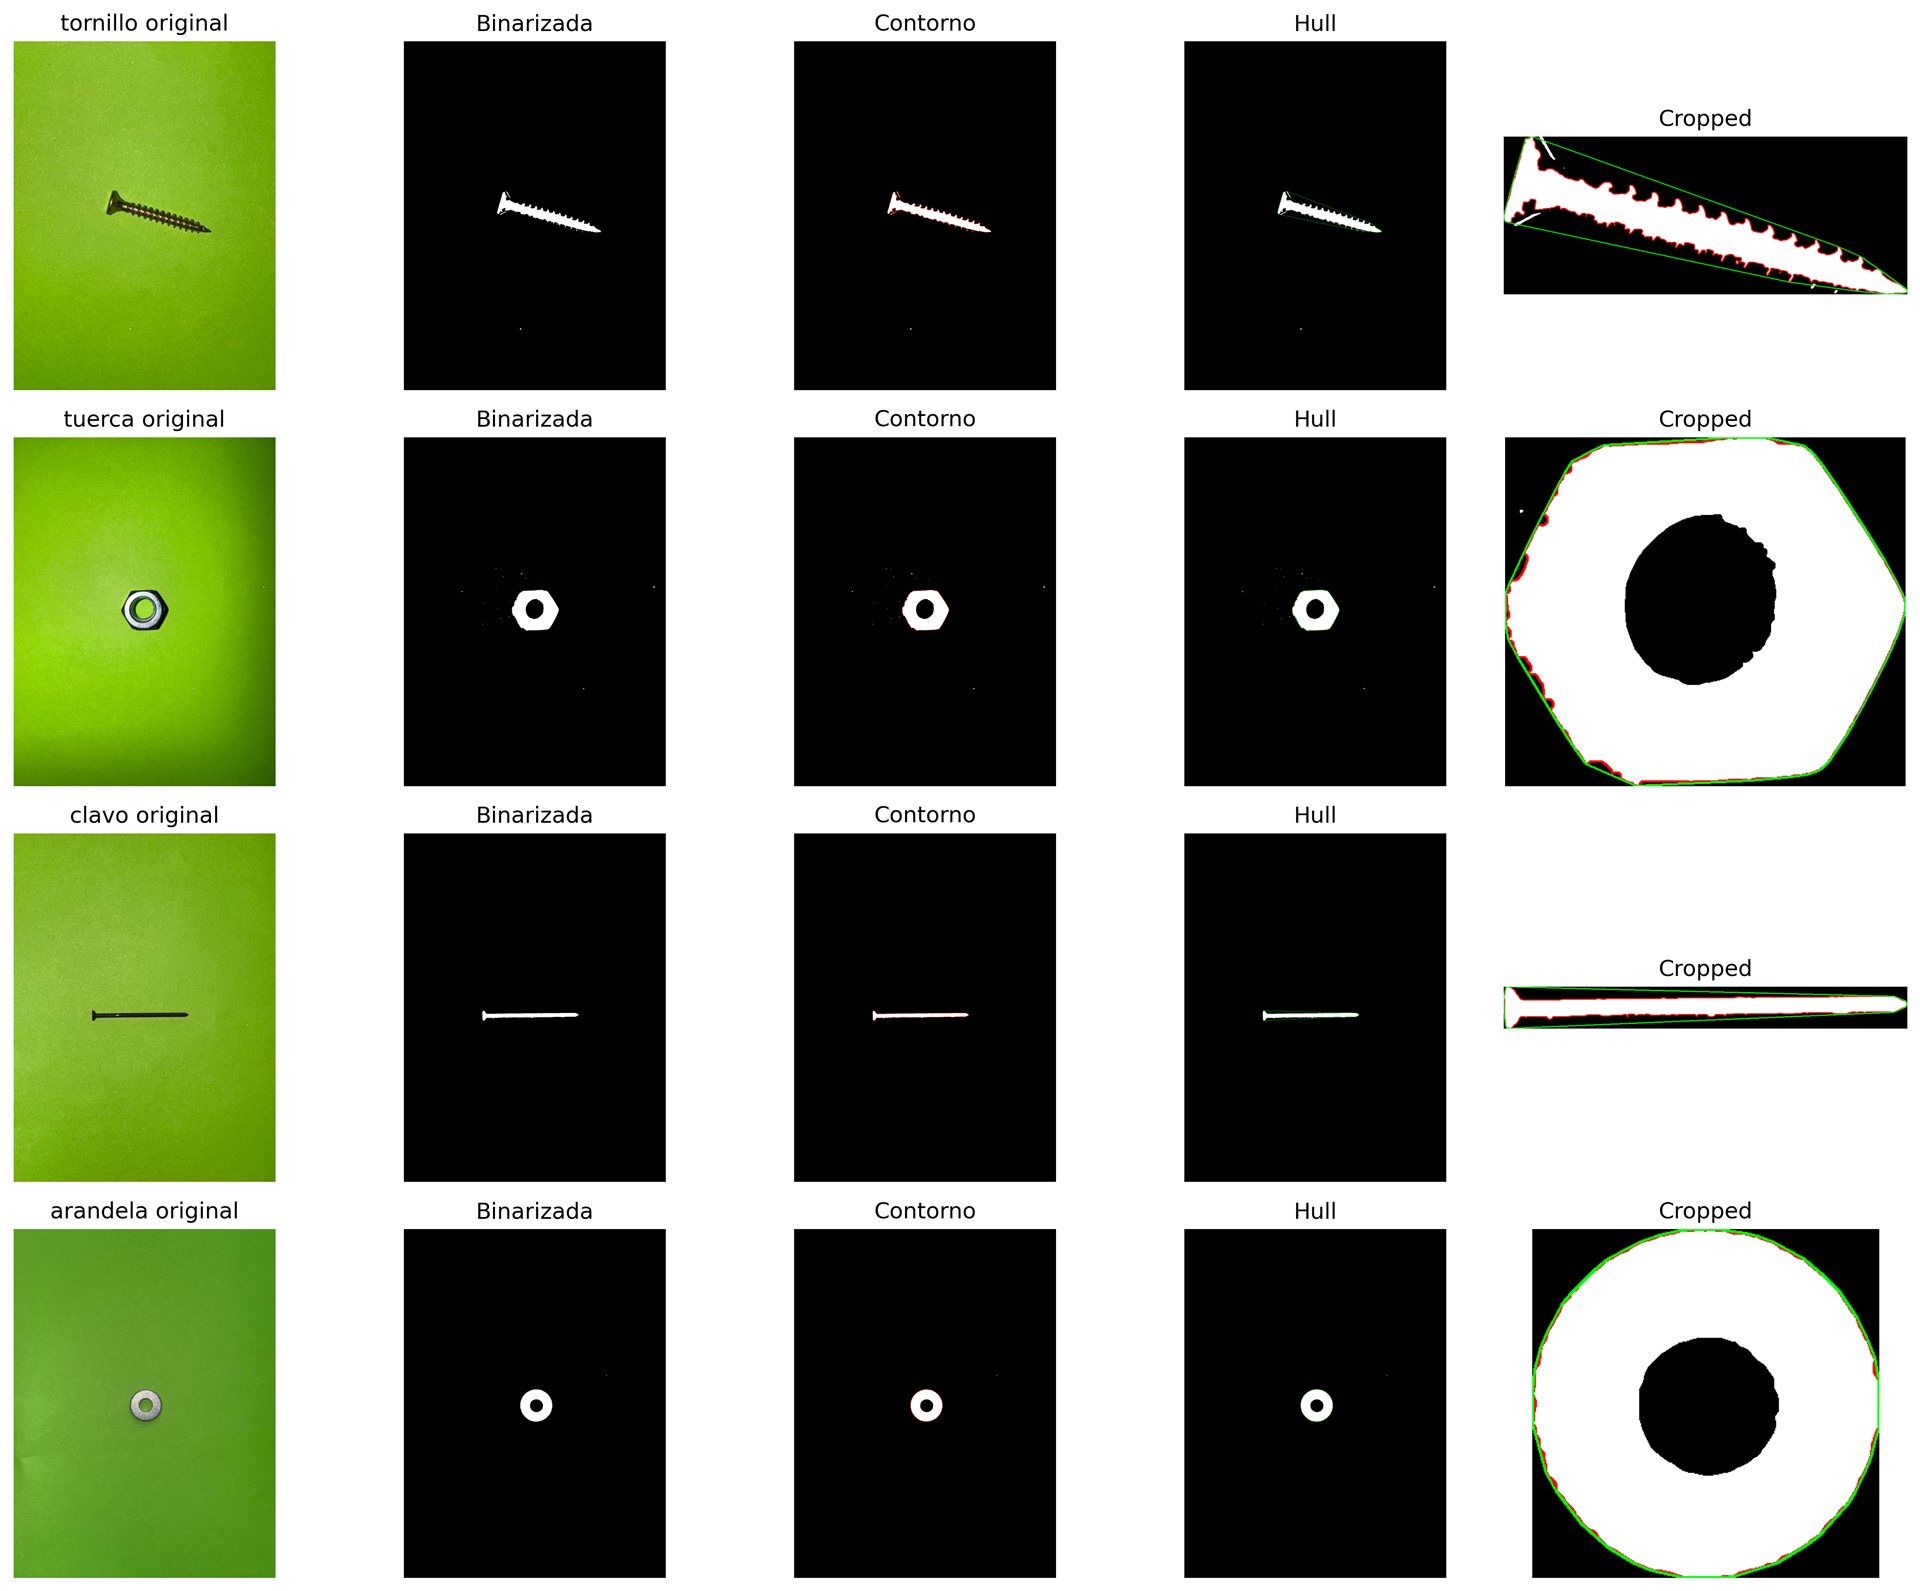
Todas las fotos se sacaron con la cámara de un celular, con flash, sobre una cartulina verde uniforme. Así la pieza es lo único que no es verde y la segmentación se simplifica. El costo es la robustez: el pipeline espera ese fondo y no funcionaría sobre una mesa con otras cosas.
Tomé alrededor de 30 fotos por clase (clavos, tornillos, tuercas, arandelas), 120 en total, y roté las piezas asimétricas (clavos y tornillos) entre fotos para que el resultado no dependa de la orientación. También guardé series extra tomadas en la facultad (verde brillante, verde opaco, mesa de examen).
Etapa 1 — Procesamiento de imagen
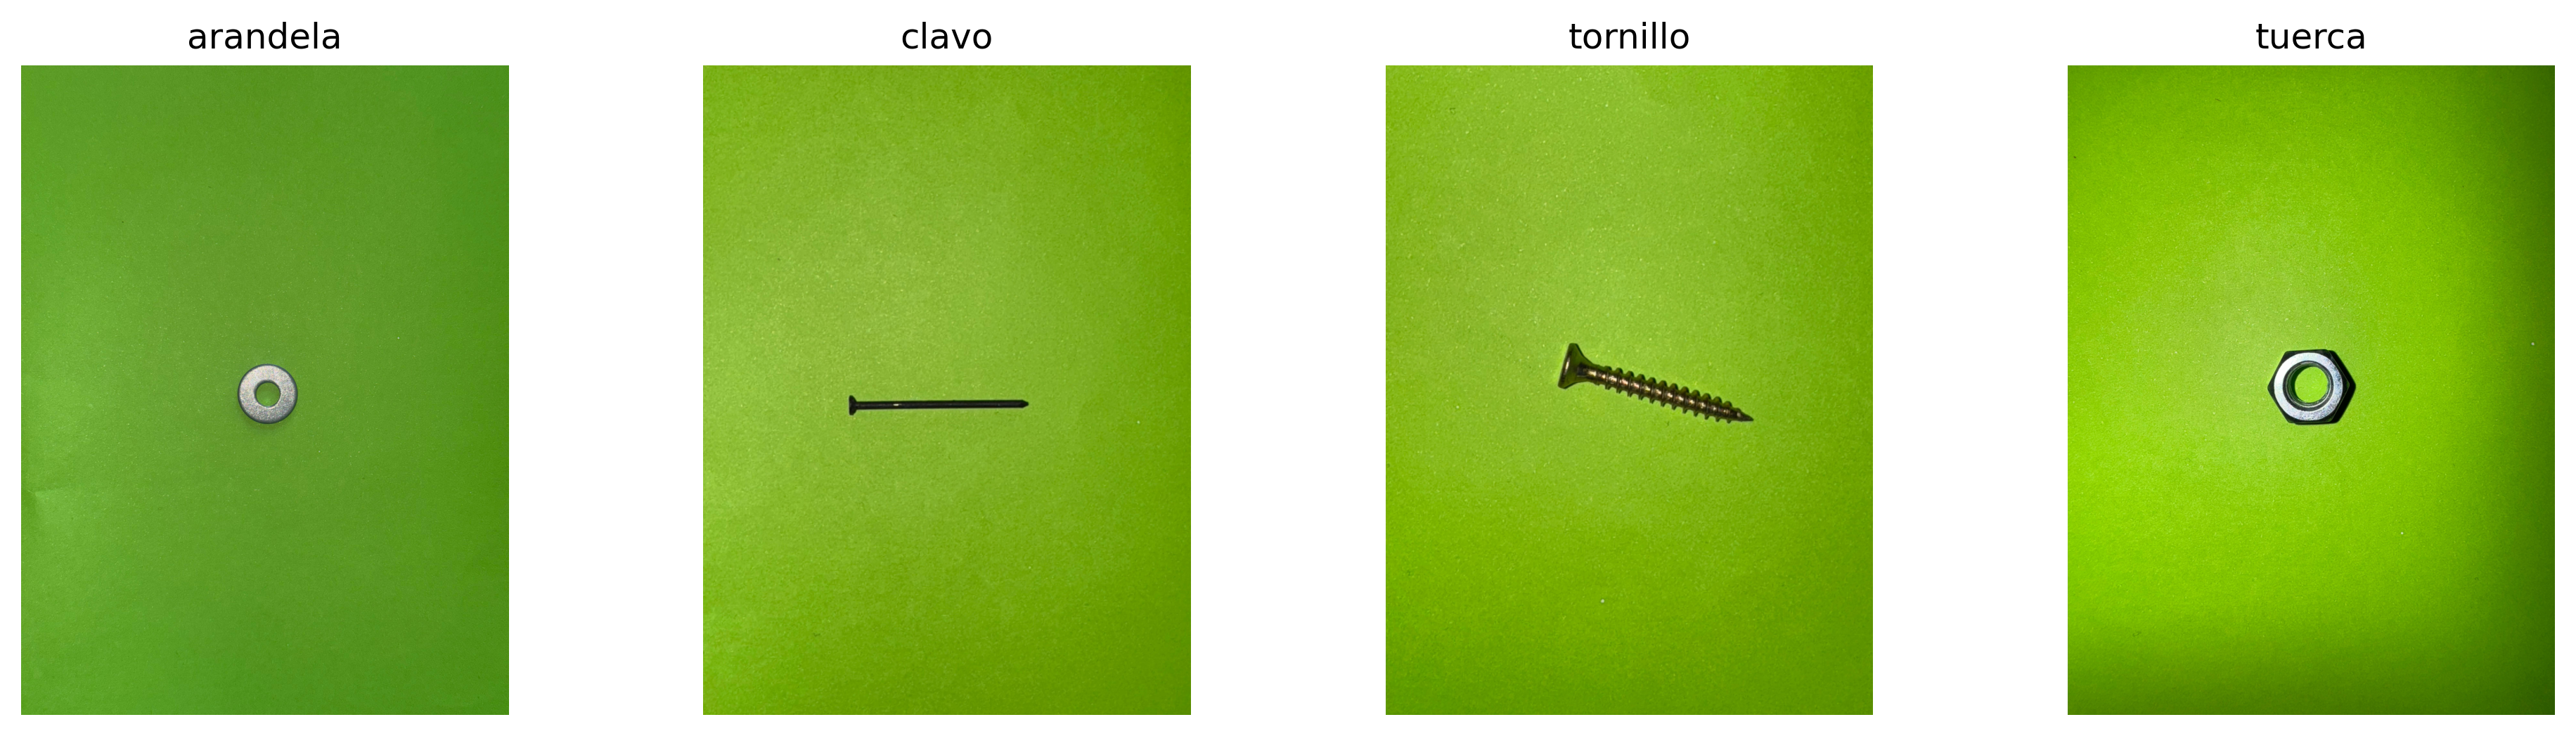
Toda la cadena está en preprocess.py y sigue el orden en que la fui armando:
- HSV: el color promedio de la foto se toma como fondo y con él se arma un rango de color; la máscara se invierte para dejar la pieza y oscurecer el fondo.
- Apertura con kernel elíptico para sacar manchas chicas.
- Escala de grises, filtro de mediana y umbral de Li para obtener una imagen binaria de la pieza.
- Cierre y relleno (flood fill) para tapar huecos internos chicos, conservando el hueco más grande para que tuercas y arandelas mantengan su centro.
- Contornos: se quedan los tres más grandes (de al menos 100 px), se recorta el rectángulo que los contiene, una segunda apertura (15×15) limpia los bordes y sobrevive solo el contorno más grande. De ahí se calcula la envolvente convexa (convex hull) para el paso siguiente.
Etapa 1 — Características
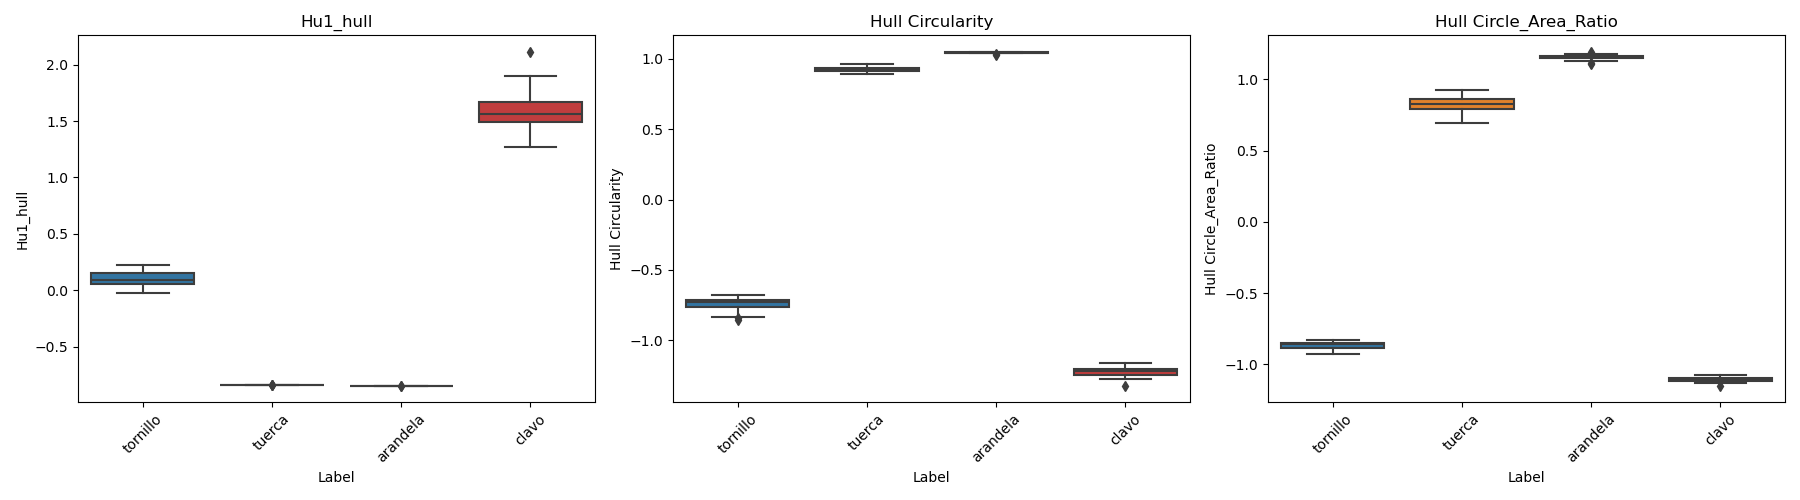
A partir del contorno y de la envolvente de cada pieza calculo 17 números (features.py): los siete momentos de Hu de la envolvente (en escala log) más área, perímetro, circularidad, circularidad de la envolvente, solidez, convexidad, relación de área con el círculo, relación de ejes, excentricidad y relación perímetro/área. Todo se estandariza con StandardScaler antes de analizar.
Los box plots por clase muestran qué características separan las cuatro piezas y cuáles no. Por ejemplo, tuercas y arandelas tienen casi el mismo Hu1, así que esa característica sola no las distingue.
Etapa 1 — Elección de tres características
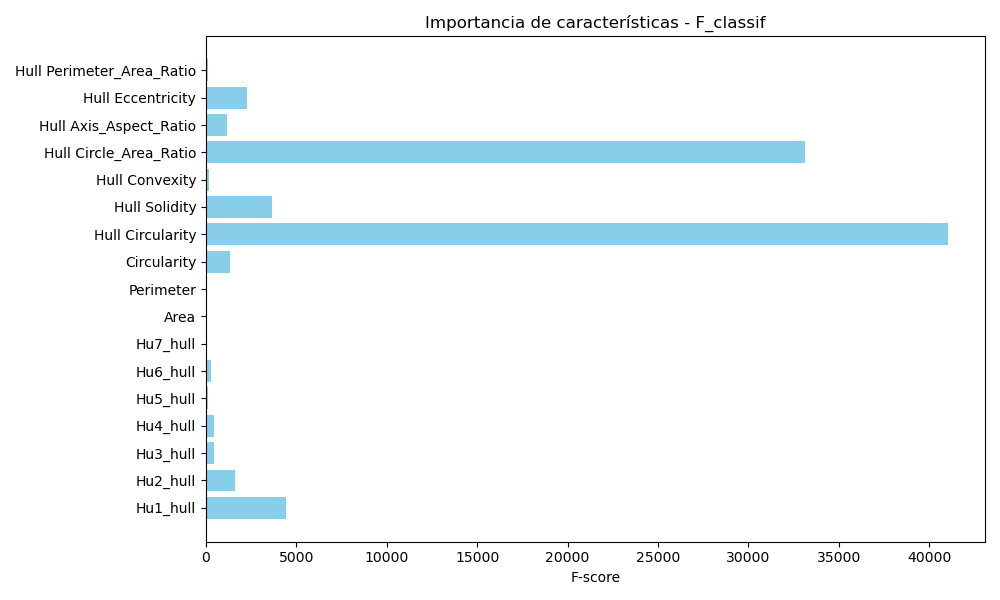
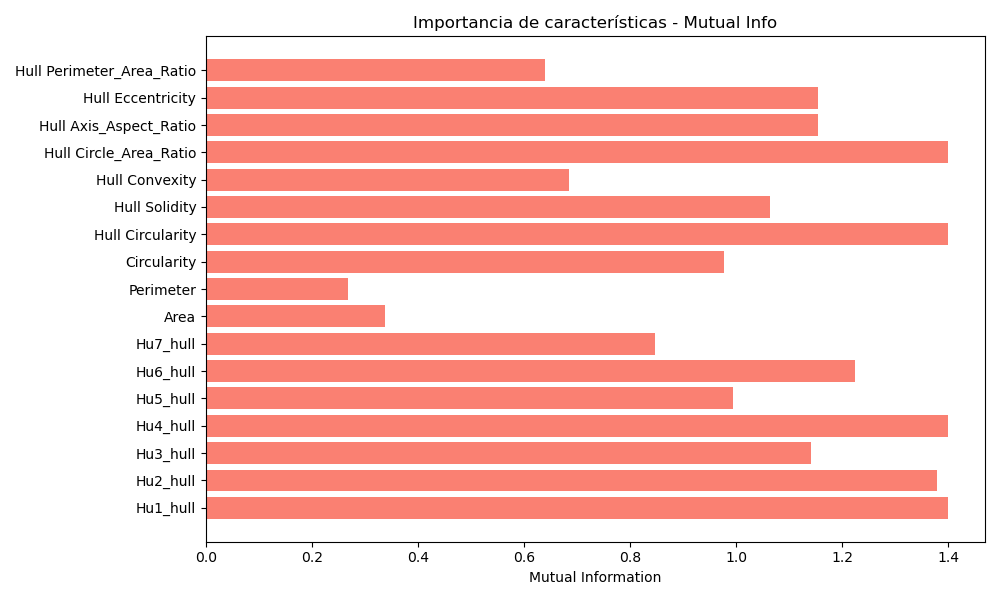
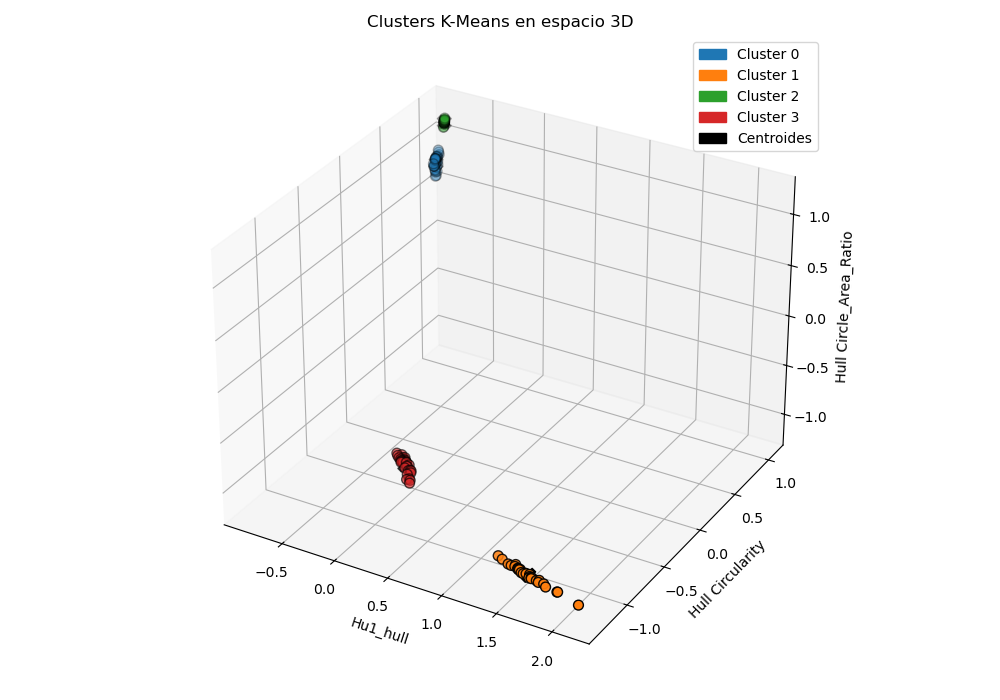
Ordené las características con dos puntajes univariados: el F-score de ANOVA (f_classif) y la información mutua (mutual_info_classif). Me quedé con Hu1 de la envolvente, la circularidad de la envolvente y la relación de área envolvente/círculo.
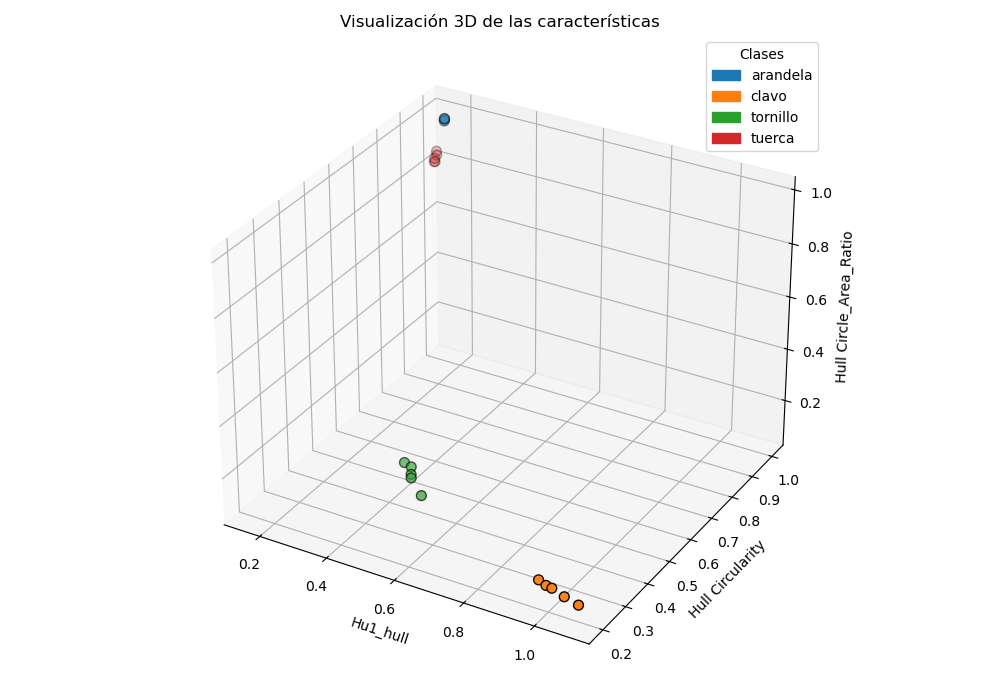
La solidez de la envolvente en realidad tiene un F-score mayor que Hu1 (1205,7 contra 832,7) pero una información mutua bastante menor (0,90 contra 1,35), y se solapa con las dos de tipo circularidad, así que la dejé afuera. Con tres características además puedo graficar cada foto en 3D y ver las clases antes de entrenar nada.
Etapa 1 — KNN y K-Means desde cero
Los dos algoritmos están escritos a mano con NumPy en models.py; scikit-learn se usa solo para el escalador, los puntajes de las características y la validación cruzada.
- KNN: distancia euclídea, k = 7, voto por mayoría.
- K-Means: 10 inicializaciones aleatorias, quedándome con la de menor varianza intra-cluster; un cluster vacío conserva su centroide anterior. Como K-Means no conoce las etiquetas, emparejo clusters y clases con el algoritmo húngaro (linear_sum_assignment) sobre la matriz de confusión para poder medir su precisión.
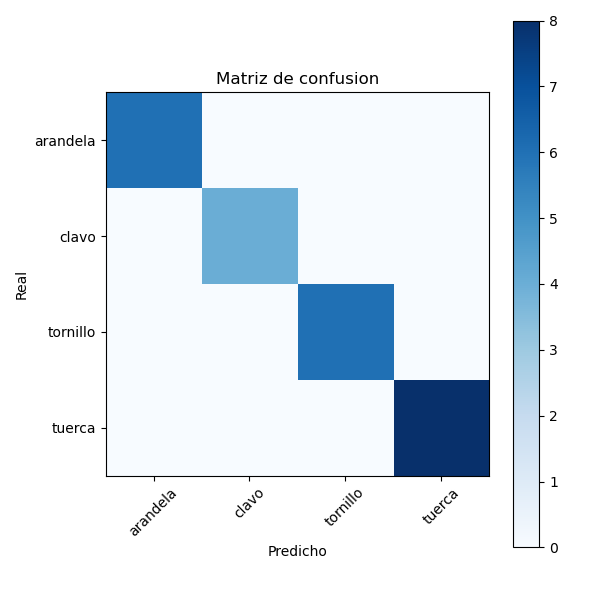
Con una partición 80/20 de las 120 fotos, KNN clasificó bien todas las fotos de test (matriz de confusión diagonal); K-Means dio un resultado menor. En los clusters 3D dos casi se superponen, algo coherente con que tuercas y arandelas tienen características parecidas. Ese 100 % sale de fotos tomadas en las mismas condiciones que el entrenamiento, así que dice poco sobre otros fondos.
Etapa 1 — Aplicación de escritorio
Para probar el clasificador lo envolví en una aplicación PyQt5 separada en modelo, vista y controlador. Se elige la carpeta de entrenamiento, se entrena, se elige una foto y se ve la máscara procesada con su contorno y envolvente, los tres valores, el punto graficado entre los datos de entrenamiento, la predicción de KNN con las etiquetas de sus 7 vecinos y su precisión por validación cruzada, y la predicción de K-Means.
Etapa 2 — Planificación STRIPS
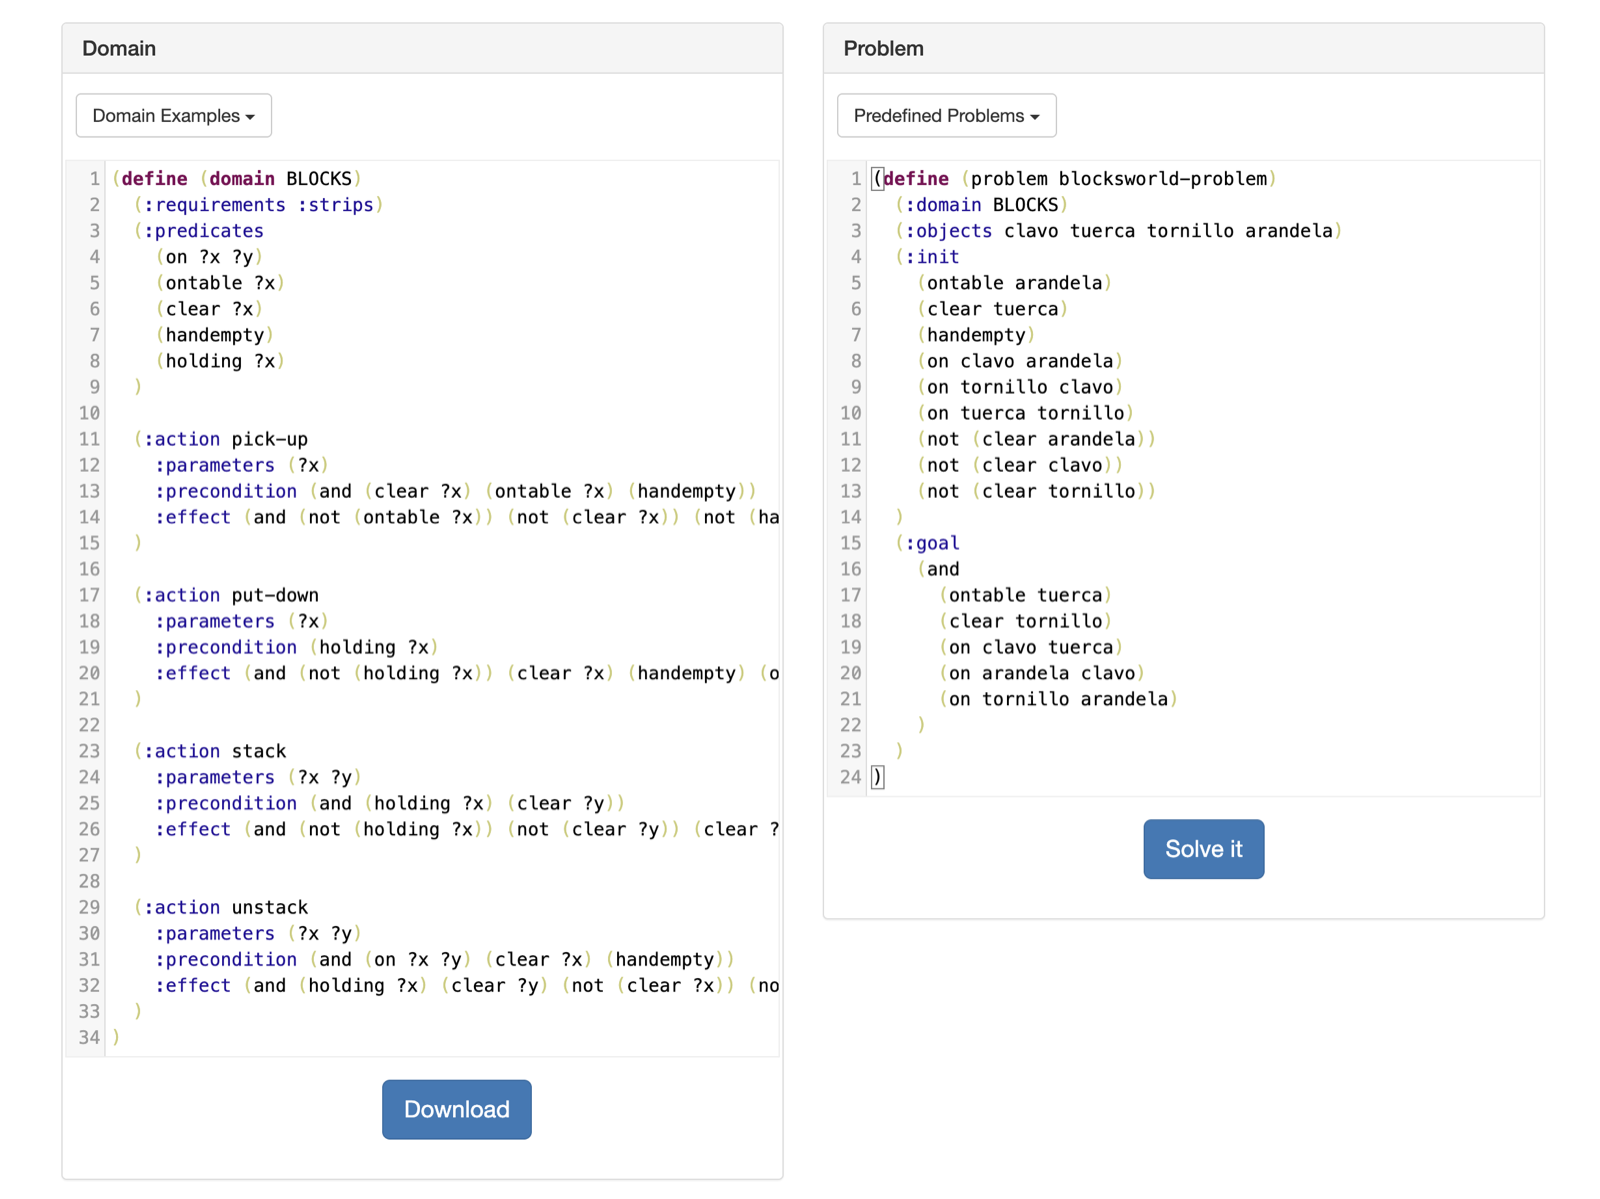
Modelé las cajas como un mundo de bloques: las cuatro piezas son los bloques, con los predicados on, ontable, clear, handempty y holding, y cuatro acciones (pick-up, put-down, stack, unstack), cada una con sus precondiciones y efectos.
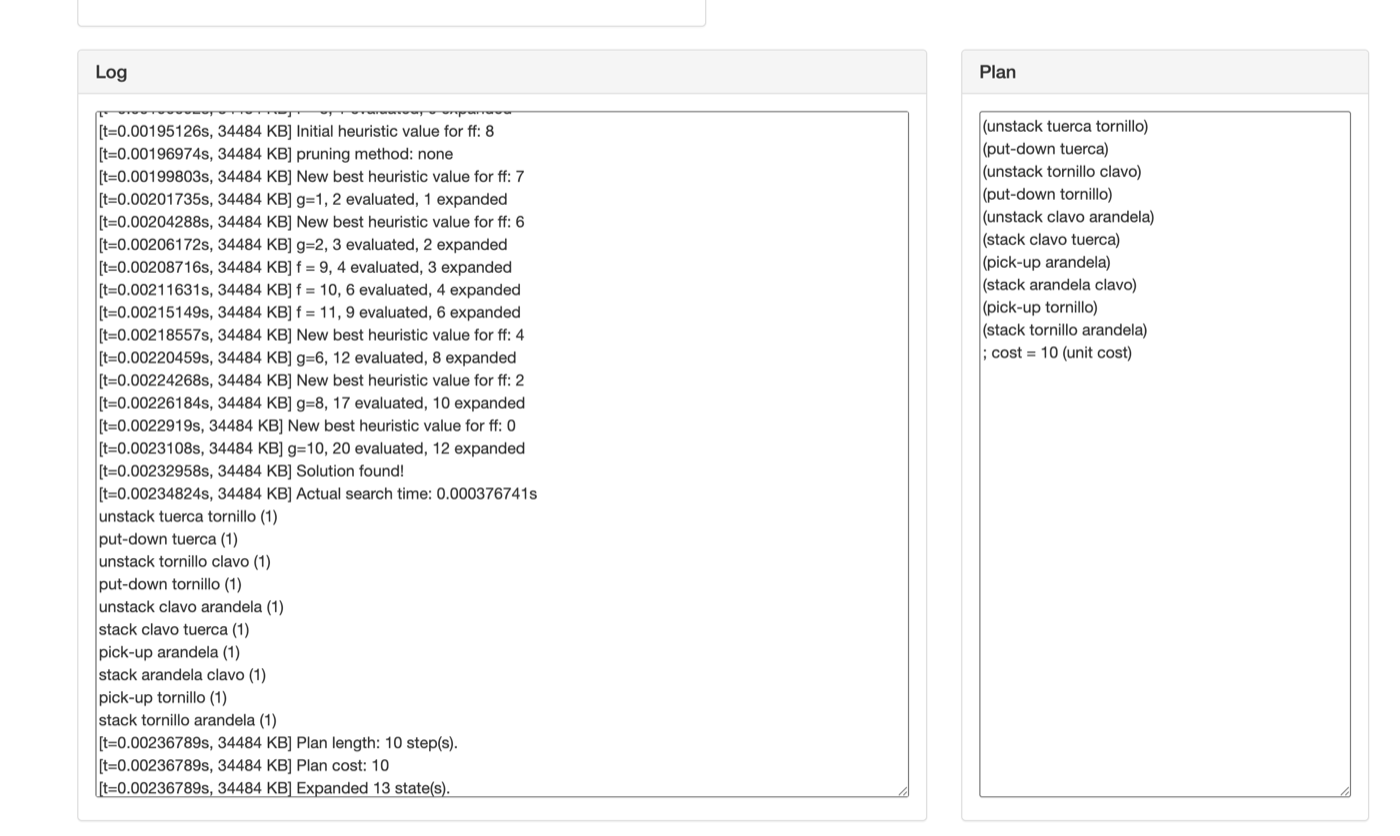
Un script en Python (etapa2.py) escribe los archivos PDDL de dominio y problema con una pila inicial y una pila objetivo aleatorias. El planificador no lo escribí yo: cargué ambos archivos en un solver PDDL online. Para el ejemplo de las capturas devolvió un plan de 10 pasos tras expandir 13 estados.
Etapa 3 — Laberinto y navegación A*
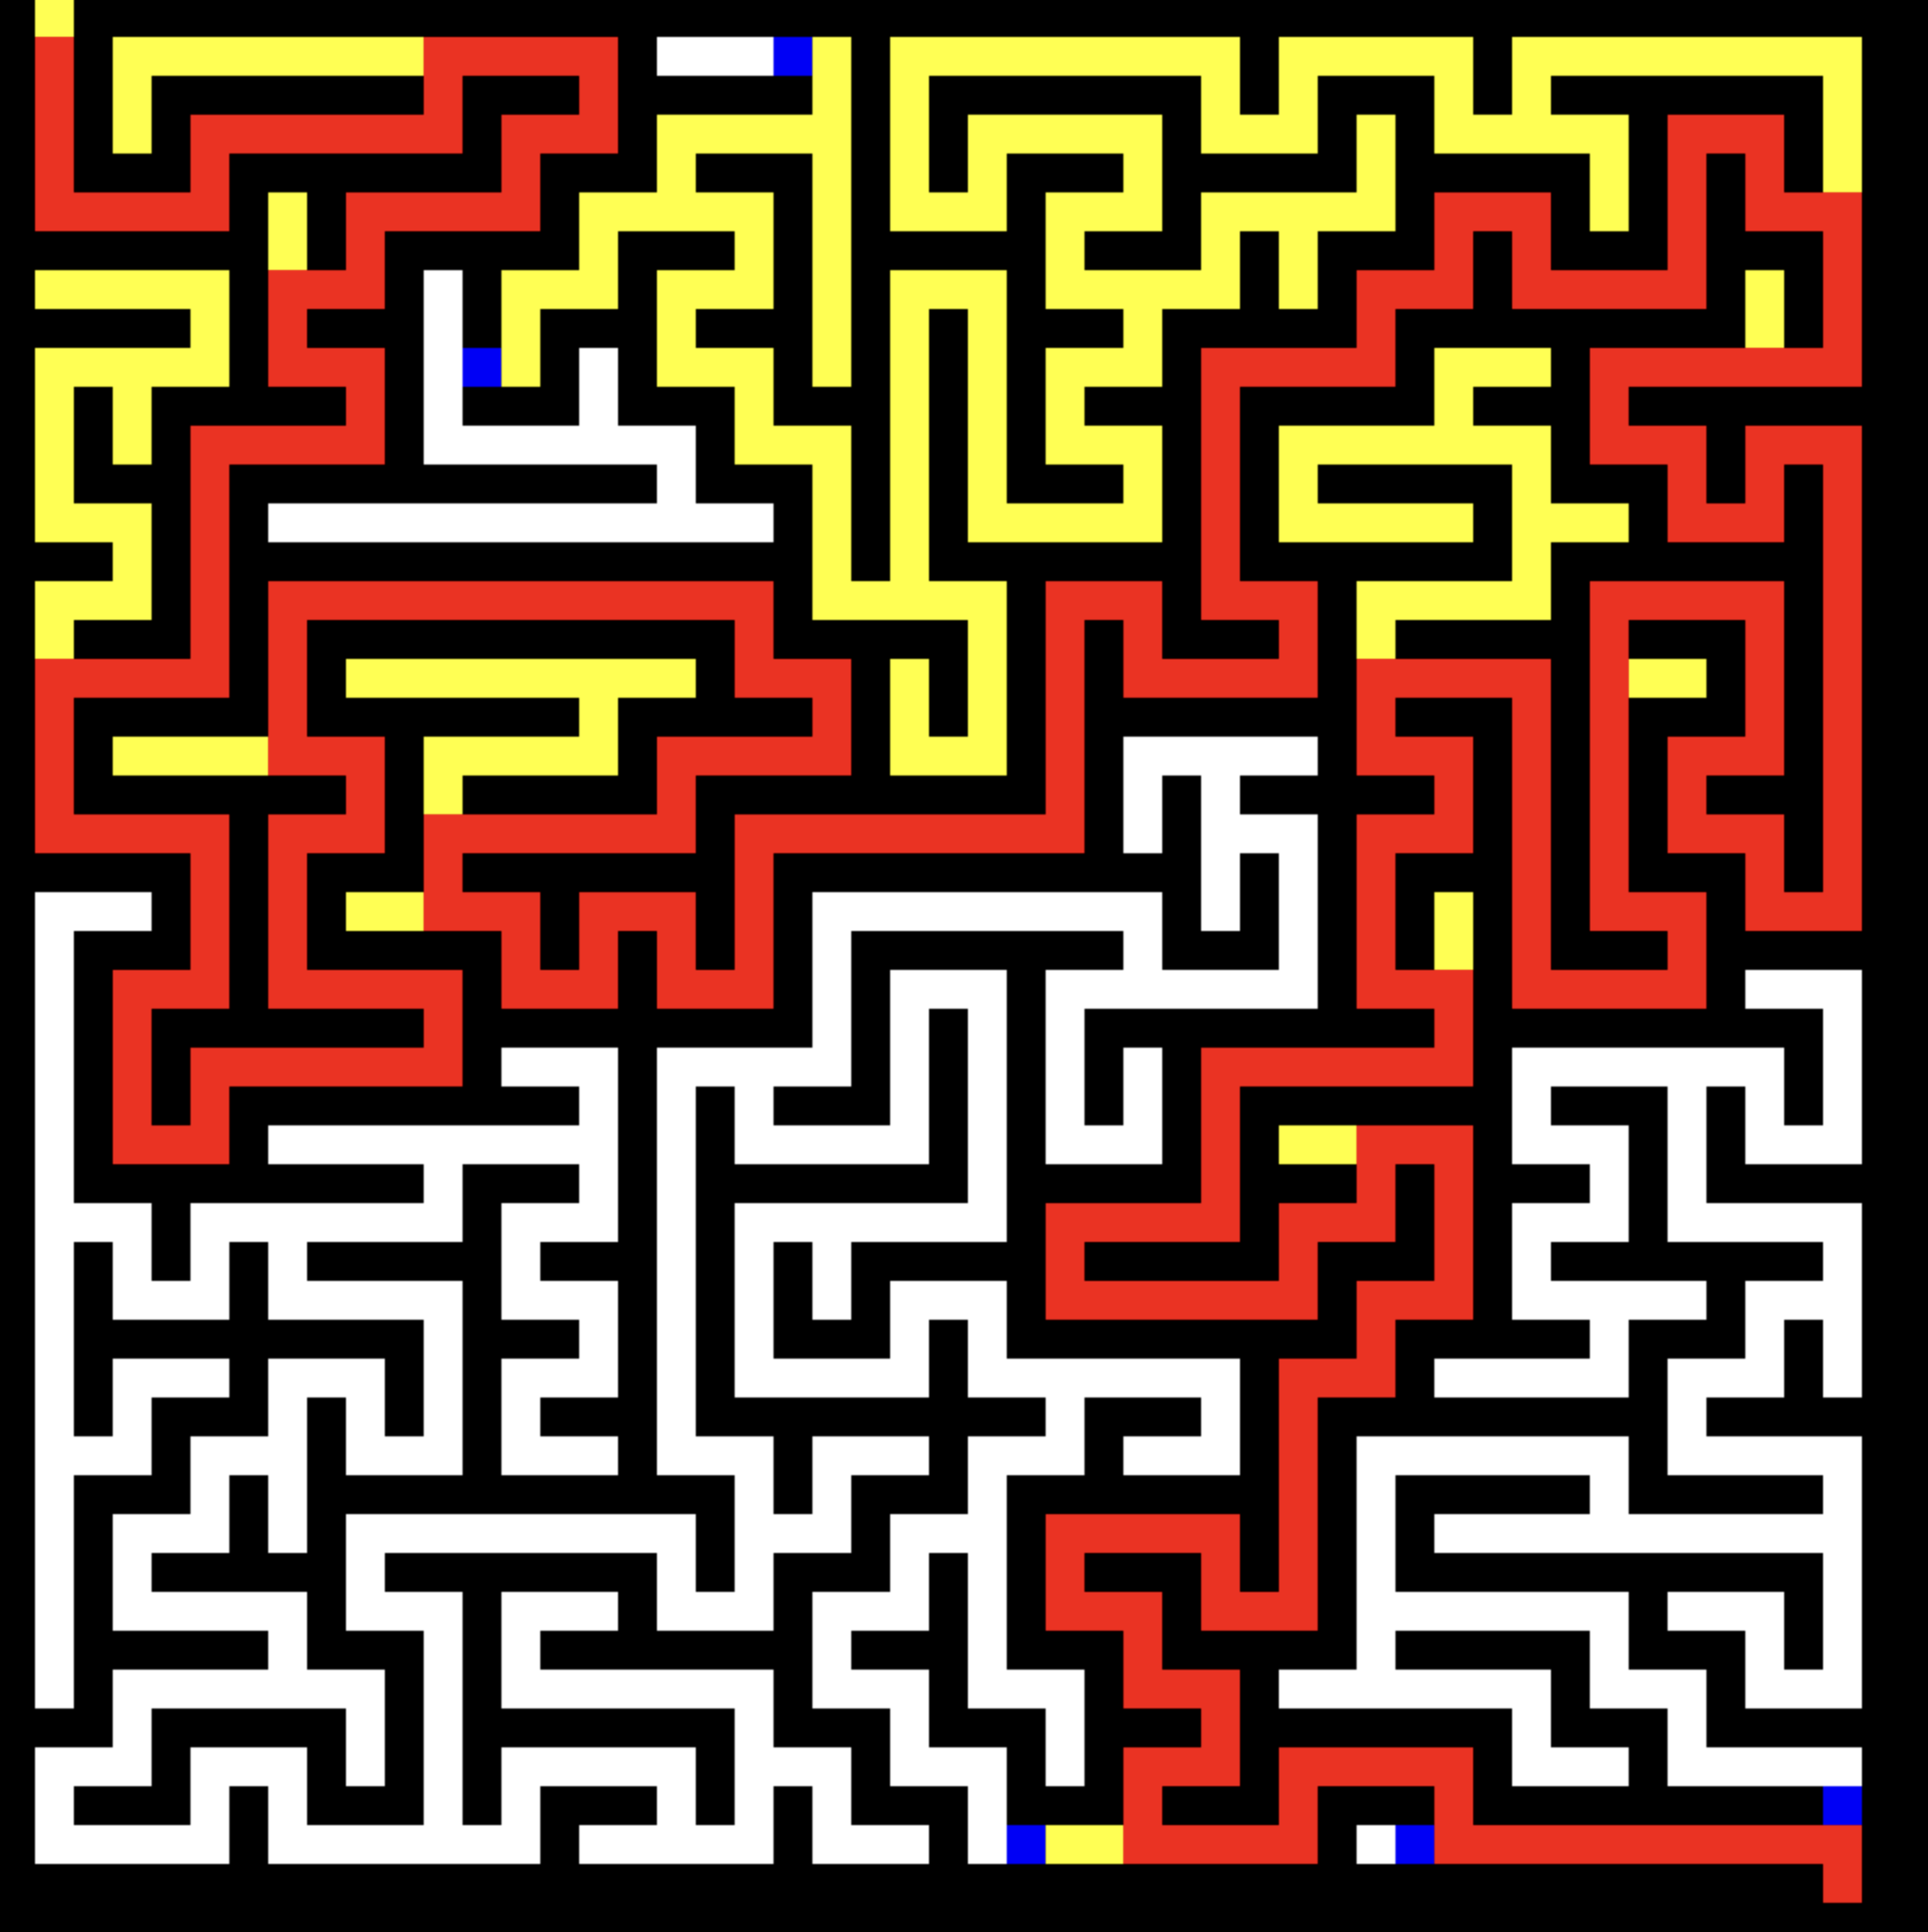
El aula es una grilla de 50×50 con celdas libres y paredes. El laberinto se genera al azar excavando en profundidad, así que siempre hay camino de la entrada a la salida.
A* corre sobre esa grilla con movimientos en cuatro direcciones y la distancia Manhattan como heurística, con una cola de prioridad (heapq). Una ventana de pygame muestra la búsqueda en vivo detrás de un botón Start: celdas en espera en azul, exploradas en amarillo y el camino final en rojo. El laberinto reemplaza al aula con mesas y sillas, así que es una simplificación del problema real.
Límites y qué mejoraría
- La etapa de visión está ajustada a un montaje controlado (cartulina verde, flash). Otro fondo pediría otra segmentación.
- Una precisión perfecta sobre cuatro clases bien separadas, probada en las mismas condiciones que el entrenamiento, no prueba que generalice.
- Las tres etapas no están conectadas entre sí y nada corre en un robot real: visión, planificador y laberinto se simulan por separado.
- Siguiente paso: alimentar el planificador con la salida del clasificador y probar con fotos sobre otros fondos e iluminación.